HBM이란?
HBM의 넓은 I/O, DRAM 적층·TSV·Base Die와 GPU 연결을 열·수율·Test까지 이어 이해합니다.
추천 읽기 순서용어사전어디까지 알아야 하나요?관련 직무
3줄 요약
- HBM은 여러 DRAM Die와 넓은 I/O를 이용해 많은 데이터를 병렬로 전달하는 고대역폭 메모리입니다.
- 대역폭은 일정 시간에 전달할 수 있는 데이터의 양입니다.
- AI 연산이 데이터를 기다리는 상황을 줄이는 데 중요한 역할을 합니다.
이 페이지 목차
이 글에서 배울 것계산을 잘해도 자료가 늦으면 기다린다대역폭과 지연시간은 다르다칩을 쌓고 옆의 연산 칩과 연결한다자주 하는 오해HBM 구조를 셀에서 시스템까지 연결하기넓은 I/O가 대역폭을 만든다연결을 늘릴 때 열·수율·Test도 함께 본다이해했는지 확인하기실무형 심화: 대역폭 숫자를 직접 계산하고 한계를 구분하기이 글에서 배울 것
HBM이 NAND와 어떻게 다른지, 대역폭이 왜 중요한지, 칩을 쌓는 것만으로 설명이 끝나지 않는 이유를 알아봅시다.
계산을 잘해도 자료가 늦으면 기다린다
많은 학생이 계산 문제를 함께 푸는데 문제지가 한 장씩만 전달된다면 어떨까요? 계산하는 능력이 충분해도 자료를 기다리는 사람이 생깁니다. AI 연산에서도 계산에 사용할 데이터를 제때 공급하는 일이 중요합니다.
HBM은 High Bandwidth Memory, 즉 고대역폭 메모리입니다. 여러 DRAM 칩을 쌓고 많은 연결을 통해 데이터를 전달하도록 설계합니다. AI 가속기 등 데이터 전달량이 중요한 시스템에 사용합니다.
대역폭과 지연시간은 다르다
도로의 차선이 많으면 많은 자동차가 동시에 지나갑니다. 이것이 대역폭을 이해하는 비유입니다. 반면 한 자동차가 목적지에 도착할 때까지 걸리는 시간은 지연시간에 가깝습니다.
| 구분 | 물어보는 질문 | 예시 단위 |
|---|---|---|
| 용량 | 얼마나 보관할 수 있나? | GB |
| 대역폭 | 1초에 얼마나 전달할 수 있나? | GB/s |
| 지연시간 | 요청 후 얼마나 기다리나? | ns 등 시간 단위 |
따라서 용량이 크다, 대역폭이 높다, 지연시간이 짧다는 같은 말이 아닙니다. 도로 비유는 이 차이를 설명하기 위한 것이며 실제 메모리의 전기적 동작을 그대로 재현하지는 않습니다.
칩을 쌓고 옆의 연산 칩과 연결한다
HBM 내부에서는 DRAM 칩을 수직으로 적층하고 TSV, 즉 실리콘을 관통하는 전기 통로 등을 사용합니다. GPU 같은 연산 칩과도 패키지 안에서 많은 신호를 연결해야 합니다. 어떤 연결 구조를 쓰는지는 제품 설계에 따라 달라집니다.
수직 적층은 제한된 면적에 여러 DRAM 칩을 배치하는 데 도움이 됩니다. 하지만 적층 자체만으로 높은 대역폭이 완성되지는 않습니다. 데이터 연결의 폭과 동작 조건도 함께 설계해야 합니다.
자주 하는 오해
HBM도 저장용 Flash인가요? HBM은 DRAM 기반이므로 전원이 꺼지면 데이터를 유지하지 못합니다. 사진을 보관하는 NAND와 역할이 다릅니다.
모든 AI 작업은 HBM만 늘리면 빨라지나요? 데이터 전달이 병목인 경우 효과를 기대할 수 있습니다. 계산 자체나 다른 단계가 병목이면 개선 폭은 달라집니다.
HBM 구조를 셀에서 시스템까지 연결하기
HBM의 적층·데이터 연결·열 경로
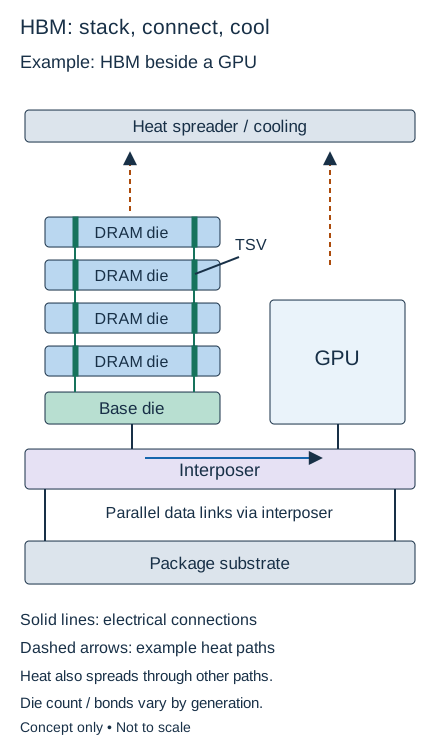
DRAM die는 메모리 칩, Base die는 하부 베이스 다이입니다. TSV는 실리콘을 관통하는 연결입니다. 데이터는 인터포저 배선을 통해 GPU와 오갑니다. 점선 화살표는 위쪽 냉각부로 향하는 열 경로의 예입니다.
그림을 읽을 때: 일반적인 2.5D 연결의 기능 개념도입니다. 다이 수·본딩·베이스 다이 구성은 세대별로 다릅니다. 열은 다른 경로로도 퍼지며, TSV를 그렸다고 열 해석 결과를 나타내는 것은 아닙니다.
그림 크게 보기HBM은 많은 I/O를 통해 데이터를 병렬 전달하도록 설계한 고대역폭 DRAM입니다. 적층은 좁은 면적에 용량과 연결을 구현하는 수단이며, 쌓는 것 자체가 대역폭의 전부는 아닙니다.
| 구성 | 무엇을 하는가? |
|---|---|
| DRAM Die | DRAM 셀과 주변 회로가 데이터를 저장·읽기 |
| Stack | 여러 DRAM Die를 수직 배치 |
| TSV / Die-to-Die Connection | 실리콘 내부 관통 배선과 칩 사이 연결로 신호 전달 |
| Base Die | Stack 하부에서 메모리와 외부 연결을 이어주는 회로·인터페이스 역할 |
| Wide I/O Interface | 많은 데이터 경로를 병렬로 사용 |
| Interposer / Package | HBM과 연산 칩 사이의 신호·전력·열 경로 구현 |
| GPU / AI Accelerator | 전달받은 데이터로 병렬 연산 수행 |
표는 기능과 연결을 살펴보는 순서입니다. TSV·접합·Base Die·I/O가 모두 독립된 칩으로 차례로 놓인다는 의미가 아닙니다. 실제 구성·접합 방식·Base Die의 회로 범위는 세대와 제품에 따라 다릅니다.
대표적인 2.5D 구성에서는 HBM Stack과 GPU/AI 칩이 Interposer 등을 통해 옆으로 연결됩니다. GPU를 HBM 위에 항상 쌓는 구조로 오해하지 마세요. 삼성의 첨단 패키징 소개에서 2.5D와 3D 연결의 차이를 확인할 수 있습니다.
넓은 I/O가 대역폭을 만든다
도로 비유에서 핵심은 층수보다 동시에 통과할 수 있는 차선입니다. 이론 대역폭은 대략 ‘데이터 I/O 수 × 각 I/O의 전송률’로 생각할 수 있습니다. Gbit/s를 GByte/s로 바꿀 때는 8비트가 1바이트라는 단위도 확인해야 합니다.
적층·TSV·칩 간 접합과 짧고 촘촘한 패키지 연결은 많은 경로를 구현하는 데 중요합니다. 하지만 실제 전달량은 접근 패턴·프로토콜·활용률 등의 영향도 받습니다. 이론 대역폭이 커도 모든 작업의 지연시간이나 성능이 같은 비율로 개선되는 것은 아닙니다.
연결을 늘릴 때 열·수율·Test도 함께 본다
HBM 지원자는 DRAM 셀의 저장·Refresh 문제와 적층 연결·열·조립 문제를 구분해보세요. 공정·소자는 셀과 재료 특성, 패키징은 연결·접합·열 경로, 제품 평가는 Die와 Stack의 동작·불량·Test 조건을 서로 연결합니다.
심화 확인: DRAM Die를 더 많이 쌓으면 대역폭도 무조건 같은 비율로 늘어날까요?
적층 수와 용량, I/O 폭과 전송률은 다른 설계 변수입니다. 높은 대역폭은 넓은 병렬 인터페이스와 연결 구조가 함께 구현해야 합니다. 열·전력·Test·수율과 시스템 병목도 확인합니다.
이해했는지 확인하기
질문: 32GB라는 숫자만 보고 HBM의 대역폭을 알 수 있을까요?
알 수 없습니다. 32GB는 용량입니다. 대역폭은 GB/s처럼 시간당 전달량으로 따로 확인해야 합니다.
한 단계 더 · 엔지니어는 무엇을 볼까?
연결 성능과 함께 전력, 발열, 조립 수율을 봅니다. 수율은 만든 제품 중 정상적으로 동작하는 제품의 비율입니다. 칩을 많이 쌓을수록 연결과 열 관리도 함께 중요해집니다.
실무형 심화: 대역폭 숫자를 직접 계산하고 한계를 구분하기
대역폭은 인터페이스 데이터 폭(bit) × 전송률(bit/s per I/O) ÷ 8(bit/byte)로 이론적인 데이터 전송률을 개산할 수 있습니다. 아래는 특정 HBM 세대나 업체 제품 Spec이 아닌 가상 인터페이스를 가정한 산술 연습입니다.
| 가상 조건 | 값 | 의미 |
|---|---|---|
| I/O 데이터 폭 | 1,024 bit | 한 전송에서 병렬 데이터 경로 |
| I/O당 데이터 전송률 | 8 Gb/s | 핀당 초당 비트 수 |
| 계산된 이론 대역폭 | 1,024 × 8 ÷ 8 = 1,024 GB/s | 십진 기준 1.024 TB/s |
| 임의 용량 | 24 GB | 저장 가능 데이터량이며 대역폭 계산에 직접 대입하지 않음 |
주의: 위 식은 전송률을 이미 초당 비트 수로 정의한 경우입니다. DDR(Double Data Rate)의 양 에지 전송을 또 2배로 곱하면 이중 계산할 수 있습니다. 실제 응용이 얻는 지속 대역폭은 액세스 패턴·Bank/Channel 병렬성·Refresh·프로토콜 비효율·메모리 컨트롤러·연산기·패키지의 전력/열 제한 등에 영향을 받으므로 위 이론값과 다릅니다. 여러 Stack 대역폭을 합할 때에도 동시 활용 가능한 조건이 필요합니다.
HBM Stack 높이가 증가하면 용량을 늘릴 수 있지만, 이것만으로 데이터 폭·핀당 속도·실효 대역폭이 같은 비율로 늘지는 않습니다. TSV/접합 수율, 테스트 접근성, 전원 무결성, 발열을 함께 비교해야 합니다. 구조·기계적 결함과 시스템 성능 부족도 동일한 증거가 아닙니다.
직접 계산해보기: 1,024-bit × 8 Gb/s는 왜 8,192 GB/s가 아닌가요?
폭과 핀당 전송률을 곱하면 8,192 Gb/s입니다. 바이트 환산을 위해 8로 나누면 1,024 GB/s(=1.024 TB/s)가 됩니다. GB(용량)와 GB/s(대역폭), Gb/s(비트/초)를 구분하세요.
학습 근거: Micron 공식 HBM 기술 소개, Micron HBM4 설명 — 용량과 대역폭. 여기의 1,024-bit·8 Gb/s·24 GB 조합은 학습 편의를 위한 가상 숫자로 제조사 특정 제품에 귀속되지 않습니다.
비유와 학습 예시는 이해를 돕기 위해 작성했습니다.
어디까지 알아야 하나요?
아래는 HBM의 학습 목표입니다. 직무별 모듈에서 필요한 수준을 함께 확인하세요. 회사의 공식 평가 기준이나 합격 기준은 아닙니다.
설명할 수 있어야 합니다
대역폭과 지연시간, 연산·메모리 병목의 구분
설명할 수 있어야 합니다
DRAM 적층, TSV, 칩 간 접합, 패키지 연결
생각해볼 수 있어야 합니다
대역폭·용량·열·수율·테스트의 함께 보기
더 깊게 연결해보세요
시스템 관점의 연결·전력·열 제약
이 기술을 이해했나요?
공통 기초 · HBM은 왜 AI 시스템에서 중요할까요?
연산기에 많은 데이터를 공급하기 위한 넓은 인터페이스와 적층 메모리 구조를 제공합니다. 높은 대역폭이 모든 접근 지연을 없애지는 않습니다.
직무 핵심 · TSV와 본딩은 각각 어떤 역할인가요?
TSV는 실리콘 내부를 관통하는 전기 경로, 본딩은 칩 사이의 접합입니다. 세대·제품의 실제 연결 방식은 공식 제품 자료로 확인합니다.
실무 연결 · 적층을 늘렸는데 어떤 문제를 함께 봐야 할까요?
열 배출, 전력, 연결 품질, 기계적 변형과 각 Die·적층 후 테스트를 함께 평가합니다. 셀 미세화와 패키지 과제를 분리합니다.
심화 · 대역폭만 높이면 시스템 성능도 같은 비율로 높아질까요?
연산량, 접근 패턴, 통신·전력·열 제한과 다른 병목에 따라 달라집니다. 이론 대역폭과 실제 활용률을 구분합니다.
면접 키워드와 연결하기
관련 기술
함께 살펴볼 기술
3D NAND 수직 스트링·전하 포획층 구조와 불량 메커니즘
3D NAND의 BL·SSL·적층 WL·수직 채널·GSL·Source Line 구조도와 Charge Trap 단면, Program/Read/Erase 및 주요 공정 불량을 이해합니다.
DRAM 셀·어레이 구조부터 읽기와 불량 메커니즘까지
1T1C DRAM의 Word Line·Bit Line·커패시터·Sense Amplifier 구조도를 따라 읽기, 전하 공유, 복원, 리프레시와 제조 불량을 연결합니다.
DRAM 주요 공정 변화: 작게 만들고 전하 지키기
미세화·EUV·커패시터·HKMG·배선 변화의 이유를 배우세요.