직무별 대학생 프로젝트: 가상 데이터로 분석부터 설명까지
DOE·PE Test Bin·Chamber 센서·Wafer Map/SPC를 CSV와 Python으로 재현하고 결과의 한계를 설명합니다.
3줄 요약
- DOE·PE Test Bin·Chamber 센서·Wafer Map/SPC를 CSV와 Python으로 재현하고 결과의 한계를 설명합니다.
- 공식 근거·교육용 제안·가상 데이터의 범위를 구분합니다.
- 관찰된 차이는 가설의 출발점이며 원인 검증과 후속 평가가 필요합니다.
이 페이지 목차
시작하기: 네 프로젝트 모두 가상 데이터입니다데이터와 분석 코드 다운로드① 공정기술: DOE로 조건 비교하기② PE: Test Bin과 Yield 분모 검증하기③ 설비: Chamber 압력과 센서의 불일치 찾기④ 제조 Data·AI: Wafer 영역과 SPC 시계열 시각화제출할 산출물과 예상 질문다음 학습과 참고 자료종합 수율 분석 과제시작하기: 네 프로젝트 모두 가상 데이터입니다
실제 기업 데이터·공정 Recipe·운전 기준·확정 원인을 제공하지 않습니다. 기존 DOE·PE 데이터·압력 원리·Wafer Map 실습를 선수 학습으로 사용하고, 여기서는 파일을 내려받아 계산과 해석을 재현합니다. 실제 생산 현장에서 이 조건을 적용하면 안 됩니다.
데이터와 분석 코드 다운로드
CSV 4개와 분석 코드 analyze.py를 같은 폴더에 저장합니다. Python 3 표준 라이브러리만 사용하며 별도 패키지·계정·서비스가 필요 없습니다. 그 폴더에서 python3 analyze.py를 실행하면 아래 결과가 JSON으로 출력됩니다. Excel에서도 같은 집계·표·그래프를 만들 수 있습니다. 파일은 학습용이며 이 사이트로 결과를 업로드하지 않습니다.
| 파일 | 단위·구조 | 가상 생성 규칙 |
|---|---|---|
| doe.csv | 정규화 인자 A/B(−1,+1), 반복 번호, 수율 지표(%) | 2×2 조합별 3회, 고정 seed로 순서 섞음. 별도 가상 확인 데이터 3회 |
| pe.csv | Site별 고유 제품·최초 합격·서로 배타적 Bin·재검 수·회복 수 | S1/S2 각각 500개, 실제 고객/제품 ID 없음 |
| equipment.csv | 1분 간격 30점, 공급·주 센서·독립 기준 압력(kPa), 상대 유량 | 첫 20점 기준, 이후 10점 주 센서와 기준값 불일치. 압력은 교육용 임의 단위 수준 |
| wafer-spc.csv | 시간별 검사 100 Die의 Fail 수, 별도 공간 패턴 집계 | SPC 30시점과 Center/Edge/Ring/Cluster 4개 독립 가상 지도 집계 |
네 데이터는 같은 물리적 제품이나 한 공정 실험에서 나온 자료가 아닙니다. Equipment 압력은 가상 gauge 값이며 실제 설정치·운전 허용 범위가 아닙니다. 상대 유량 100은 실제 유량 단위가 아닙니다. Wafer 파일은 실제 Die 좌표 원시 데이터가 아닌 영역 집계이므로 실제 공간 형상·결함 위치를 복원할 수 없습니다.
① 공정기술: DOE로 조건 비교하기
목표: 인자 효과와 조합에 따른 차이를 계산하고 검증 가능한 최적화 후보를 고릅니다.
선수 지식: 평균, 분포, DOE. 데이터는 doe.csv입니다.
분석 단계
screen12행과confirmation3행을 분리합니다. 확인 데이터를 모델 선택에 섞지 않습니다.- 각 A/B 조합의 평균과 반복 범위를 비교합니다. 실제 실험에서는 무작위화·독립 반복·시간/장비 블록을 계획해야 합니다. 가상 반복의 노이즈는 자연 공정 분포를 증명하지 않습니다.
- A의 +1/−1 그룹 평균 차이, B의 차이와 A×B 부호 그룹 차이를 계산합니다.
- 높은 평균 조합을 후보로 정하되 비용·손상·품질 제약은 미측정임을 적습니다.
- 가상 확인 데이터의 평균을 별도로 계산하고 실제 검증에 필요한 추가 Lot·측정 항목을 설계합니다.
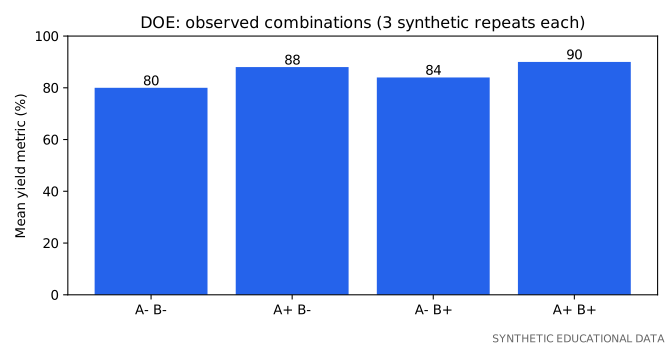
재현 결과: 조합 평균은 (−1,−1)=80%, (+1,−1)=88%, (−1,+1)=84%, (+1,+1)=90%입니다. A 주효과 +7%p, B +3%p, AB −1%p입니다. 이는 coded factorial effect(높은 부호 평균−낮은 부호 평균)이며 회귀계수는 이 값의 절반입니다. A 효과가 B 수준에 따라 8%p와 6%p로 달라집니다. 가상 확인 평균은 90%입니다.
결과 해석: 관측 조합 중 높은 평균인 후보일 뿐 연속 조건 전체의 최적점·인과관계·신뢰성 개선을 증명하지 않습니다. 실제 공정에 적용할 온도/시간 값이나 유의확률은 제시하지 않습니다.
면접 활용: “가상 2수준 DOE에서 주효과와 상호작용을 계산하고, 보지 못한 품질 지표를 제약으로 남겼습니다.” 공정기술
② PE: Test Bin과 Yield 분모 검증하기
목표: 최초/재검 결과를 분리하고 Site별 편중의 대안 가설을 만듭니다.
선수 지식: Test Flow, PE Test Data. 데이터는 pe.csv입니다. 기존 PE 글의 90→93% 예제를 파일로 재현하며 같은 개념의 새 설명을 반복하지 않습니다.
분석 단계
- Site별
first_pass + bin_a + bin_b = tested_units인지 검사합니다. - 최초 수율과 고유 제품 누적 합격률을 계산합니다. 재검 시도 수를 고유 제품 분모에 더하지 않습니다.
- Site별 최초 Fail률을 비교하고, 제품·Wafer 위치·시간·온도·Program 배정이라는 교란을 조사할 계획을 작성합니다.
- 접촉·채널 교차 검사와 동일 제품 추적을 제안합니다. 이 CSV에는 개별 제품 이력이 없어 실제 교차 검증은 수행하지 못합니다.
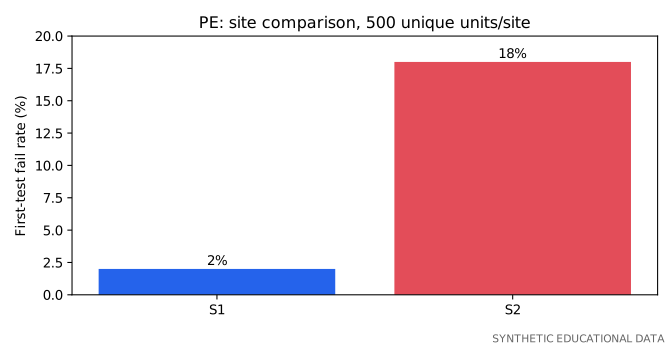
재현 결과: 최초 900/1,000=90%, 회복 30개를 반영한 누적 93%입니다. S1 최초 Fail률 2%, S2 18%로 차이는 16%p입니다. 재검 후 합격이 접촉 문제의 증명이나 장기 품질 보증은 아닙니다.
결과 해석: “Site 2가 고장”이라고 쓰지 않습니다. Bin은 전기적 실패 분류이며 구조적 원인이 아닙니다. PE의 Electrical FA와 Physical FA의 증거를 구분하고 회사별 직접 수행·협업 범위를 설명합니다.
면접 활용: “가상 집계에서 최초/재검 분모를 검증했고, Site 차이를 발견했으나 원인은 추가 추적이 필요합니다.” 평가·분석
③ 설비: Chamber 압력과 센서의 불일치 찾기
목표: 표시값 변화와 실제 압력 변화라는 가설을 구분합니다.
선수 지식: Sensor, Pressure Control, FDC. 데이터는 equipment.csv입니다.
분석 단계
- 시간·단위·gauge 기준·샘플링 간격을 맞춥니다. 실제 장비에서는 독립 기준 센서의 교정·설치 위치·응답 속도도 검증해야 합니다.
- 공급·주 센서·기준 센서·상대 유량을 같은 시간 축에 그립니다.
- 처음 20점과 이후 10점의 평균, 주 센서−기준 센서 차이를 계산합니다.
- 공통 공급·실제 Chamber 압력·센서 바이어스·계측 위치 차이 등 가설별 예상 결과를 적습니다.
- 정상 챔버 비교와 승인된 독립 계측 계획을 만듭니다. 인터록 해제나 실제 설비 조작을 수행하지 않습니다.
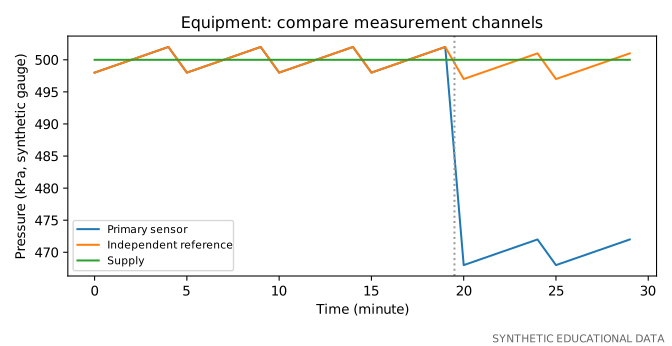
재현 결과: 주 센서 평균 500→470 kPa, 이후 기준 평균 499 kPa, 공급 평균 500 kPa입니다. 이후 주 센서−기준 평균 차이는 −29 kPa입니다.
결과 해석: 센서/계측 계통 가설을 조사할 이유가 있지만, 기준 센서가 참값이라는 보증도 없습니다. 이 가상 관측만으로 센서 고장이나 공급 이상을 확정하지 않습니다.
면접 활용: “압력 저하 표시를 즉시 Pump 고장으로 해석하지 않고 독립 계측·공통 공급·응답 차이를 분리했습니다.” 설비
④ 제조 Data·AI: Wafer 영역과 SPC 시계열 시각화
목표: 공간 집계와 시간 변동을 구분하고 평가 데이터 누출을 피합니다.
선수 지식: Wafer Map 실습, SPC, 상관관계. 데이터는 wafer-spc.csv입니다.
분석 단계
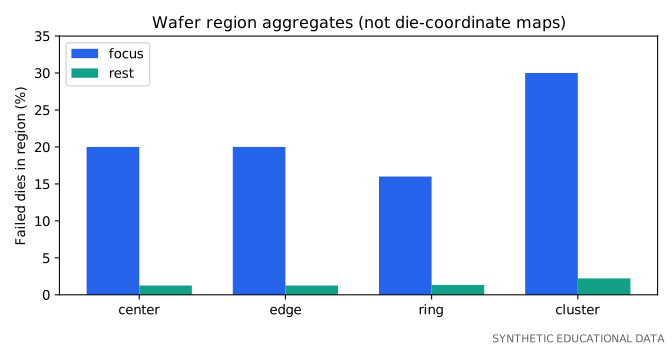
pattern=spc와 네 공간 패턴 집계를 분리합니다. 서로 다른 가상 표본을 한 시계열로 이어 붙이지 않습니다.- 각 공간 패턴의 관심 영역/나머지 검사 수를 분모로 불량률 막대그래프를 만듭니다. 실제 좌표가 없어 그림 모양을 만들어 원시 Wafer Map처럼 표시하지 않습니다.
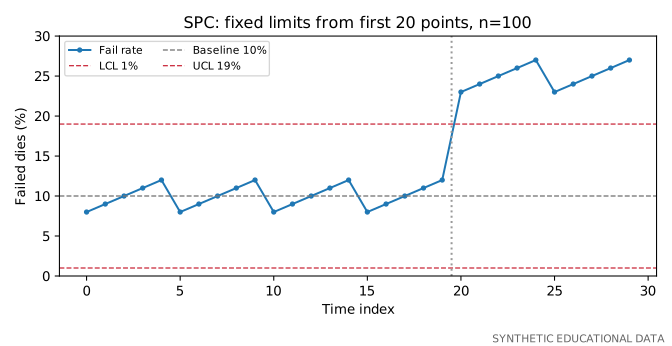
- SPC 시계열의 첫 20점만 기준으로 p-bar를 구하고, 이후 10점은 고정 관리 한계로 평가합니다.
- 검사 수 100, 독립·동일 불량확률의 이항 모형을 교육용으로 가정해
p-bar ± 3√(p-bar(1−p-bar)/n)을 계산합니다. 가정이 맞지 않으면 이 관리 한계는 적절하지 않을 수 있습니다. - 불량률 시계열과 관리 한계를 그리고 변화점 후보를 표시합니다. 실제 AI 모델을 학습했다거나 정확도를 얻었다고 보고하지 않습니다.
재현 결과: 기준 불량률 10%, LCL 1%, UCL 19%입니다. 시점 20부터 29까지의 10개 점(23%에서 27%)이 UCL을 넘습니다. 관리 한계는 제품 규격이 아니며, 이 가상 기준이 실제로 안정적이었다고 검증한 것도 아닙니다. 새 구간을 포함해 한계를 다시 계산하면 변화가 가려질 수 있습니다.
공간 집계는 기존 실습을 재현합니다. Center/Edge 20% 대 1.25%, Ring 16% 대 약 1.33%, Cluster 30% 대 약 2.22%입니다. 각 전체 불량률은 5%로 같지만 영역 비중은 다릅니다.
결과 해석: 패턴·관리 한계 초과는 원인이 아닙니다. 실제 AI 확장 시 Lot/시간 단위 학습·평가 분리와 제품·장비 변경, 클래스 불균형·표본 부족을 검토해야 합니다. 이 작은 집계 자료로 모델 성능을 주장할 수 없습니다.
면접 활용: “가상 기준 구간으로 관리 한계를 고정해 이후 변화를 감지했고, 영역 집계와 실제 좌표 지도·원인 판정을 구분했습니다.” 제조 Data·AI · 수율·품질
제출할 산출물과 예상 질문
원본 CSV → 정리/계산 파일 → 그래프 1~2개 → 관찰·대안 가설·추가 검증·한계를 적은 한 페이지 보고서를 만드세요. 결과가 예시와 다르면 분모·단위·필터·확인 데이터 분리를 먼저 점검합니다. 제공 분석 코드를 실행한 범위와 본인이 추가 작성한 분석을 구분합니다.
교육용 예상 질문: “어떤 데이터가 추가되면 결론이 바뀌나요?”, “상관과 원인을 어떻게 구분했나요?”, “검사 수가 바뀌면 관리 한계는 어떻게 되나요?” 실제 기출로 확인된 질문이 아닙니다.
다음 학습과 참고 자료
JD 읽기에서 수행한 프로젝트를 실제 담당 업무에 연결하고 면접 학습에서 문제→근거→한계를 말로 설명하세요. NPI와 Yield Ramp에서는 한 실습 결과와 양산 이관 판단이 왜 다른지 확인합니다.
- NIST Full Factorial Designs: 실험 설계 원리 참고.
- NIST Proportions Control Charts: p 관리도의 모형과 한계 참고.
- PE·센서·Wafer Map의 공식 참고 자료는 위 선수 학습 글에 있습니다. CSV·분석 코드·계산 결과·예상 질문은 자체 가상 교육 자료입니다.
종합 과제: 수율이 95%에서 85%로 떨어졌다면?
기존 네 프로젝트를 마친 뒤 수행하는 종합 과제입니다. 실제 기업·제품·장비의 기록이 아닌 자체 생성 가상 데이터입니다. 공정 조건·허용 기준·장비 운전법을 제시하지 않습니다. 정답을 추측하기보다 추가 증거에 따라 가설을 갱신하세요.
파일과 분석 경계
- observations.csv: 16개 Wafer, 2개 제품·2개 챔버·전후 2구간·각 2개 Wafer. 고유 제품 최초 검사100개/Wafer, 배타적인 Fail Bin. Edge20개/Inner80개는 미리 정한 영역 집계이며 실제 Die 좌표 Map이 아닙니다.
- followup.csv: 같은 Wafer의 표적 Fail 재접촉·별도 Contact 시험 구조와 독립 막 계측. 재검은 최초 검사와 같은 고유 제품 중 일부이며 분모에 더하지 않습니다. 시험 구조와 실제 제품 경로의 대표성은 미검증입니다.
- doe-confirmation.csv: 별도의 가상 2×2 인자 비교12행·확인3행·재발 관찰3행. A/B는 −1/+1의 익명 교육용 인자이며 실제 세정/장비 조건이 아닙니다. 확인/관찰 데이터는 모델 선택에서 분리합니다.
- integrated-yield-analysis.py: 네 파일을 같은 폴더에 놓고
python3 integrated-yield-analysis.py실행. Python3 표준 라이브러리만 사용하고 업로드·외부 접속은 하지 않습니다.
thickness_nm·cd_nm는 nm, independent_contact_ohm는 Ω, fdc_score는 단위 없는 가상 요약값입니다. 이 과제만의 예시로 막9.5~10.5 nm·CD38~42 nm를 관찰 기준으로 둡니다. 산업 공통 Spec이 아닙니다. FDC 원시 Trace·샘플링·모델은 없으므로 점수로 실제 제어 응답이나 원인을 복원할 수 없습니다. PM 이벤트와 시점도 연관 단서이지 개입 실험이 아닙니다.
해설을 열기 전에: 여덟 단계 문제
- Yield 분모·최초/재검·Pass/Bin 배타성, Program·Test 조건과 제품 구성이 같은지 검사하세요.
- 전체·제품·Lot/Wafer·챔버별 수율을 계산하고 문제 범위를 좁히세요. 작은 표본의 일반화 한계도 적으세요.
- Fail Bin과 Edge/Inner 불량률을 각각의 검사 수로 나누세요. 좌표가 없으므로 새로운 Wafer Map 모양을 원자료처럼 제시하지 마세요.
- Recipe·PM·FDC 요약과 Test 이력을 같은 Wafer 키로 연결하세요. 시점·제품·챔버가 겹치는 교란은 무엇인가요?
- Test/접촉·계면/연결·입력 패턴·측정/공정 변화 등 가설을 세우고 예측/반례를 쓰세요.
- followup.csv를 추가로 읽으세요. 재접촉 회복과 독립 저항/두께 관찰은 어느 가설을 강화·약화하나요?
- screen만으로 A/B/AB 효과를 계산한 뒤 confirmation을 보세요. 익명 인자의 효과와 물리적 메커니즘 입증은 같은가요?
- monitor에서 회복 지속성을 보고 부족한 기간·Lot·신뢰성·재발 감시를 제안하세요. “완전 해결”이라고 말할 수 있나요?
계산 해설과 판단의 한계 펼치기
1~3. 분모·범위·패턴
| 가상 관찰 | 계산 결과 | 주의 |
|---|---|---|
| 전체 최초 수율 | 전760/800=95%, 후680/800=85% | 10%p 하락, 상대 하락 약10.53%와 구분 |
| 제품별·챔버별 | A/B 각각95→85%; C1은95% 유지, C2는95→75% | 챔버와 변화 시점의 상관만 확인 |
| Edge/Inner Fail률 | 전16/160=10%, 24/640=3.75%; 후56/160=35%, 64/640=10% | 영역 분모·전체 수율과 구분 |
| Fail Bin | Contact Bin 전24→후104, Other Bin16→16 | Bin 이름은 구조적 원인의 확정이 아님 |
4~6. 추가 정보로 가설 갱신
문제군은 C2·after이며 PM E2·FDC 요약 이동이 함께 나타납니다. CD·막 두께는 예시 기준 안에 있어도 계면·연결·재료 품질은 미측정입니다. 추가 자료에서 문제 Wafer의 선택된 Fail20개 중2개만 재접촉 후 회복하고 별도 Contact 시험 구조 저항이10→15 Ω로 이동합니다. 단순 접촉 가설만으로 설명하기 어렵다는 단서가 생기지만, 표적 재검의 선택 편향·시험 구조 대표성·측정 불확도와 공정/입력 교란은 남습니다. 재검20개를 최초100개에 더하거나 이 회복 비율을 전체 회복률로 일반화하지 않습니다.
7. 별도 가상 실험
screen 조합 평균은 A−/B−=85%, A−/B+=85%, A+/B−=95%, A+/B+=95%입니다. 균형·동일 분모의 coded factorial effect는 A+10%p, B0%p, AB0%p이며 회귀계수와 구분합니다. confirmation과 monitor는 각각285/300=95%입니다. 가상 생성 모델에서 A의 반응 차이를 관찰한 것이며 A가 실제 세정·재료·공정 메커니즘이라는 뜻은 아닙니다. 확인 데이터를 선별/모델 선택에 섞지 않습니다.
8. 개선·재발 검토
독립 Lot·기간·제품·장비에서 재현, 통제된 검증, 전기/물리 중간 증거와 부작용·품질/신뢰성 평가가 더 필요합니다. 작은 가상 표로 확정 원인·양산 최적값·장기 재발 방지를 입증하지 않습니다. 제출물은 계산·관찰·가설별 증거/반례·추가 검증·미해결 항목을 분리한 한 페이지 보고서입니다.
선수: Wafer Map · DOE · PE Test Data · FDC · MSA · PI. 기존 Yield Drop 사례와 연결해 설명해보세요. 상호작용이0이 아닌 경우는 DOE 상호작용 추가 실습에서 비교하세요. 통계 원리는 NIST Full Factorial Designs를 참고하며 CSV·문제·해설·수치는 자체 작성입니다.
관련 기술
함께 살펴볼 기술
반도체 이상탐지 실습 — AI Alarm의 오탐·미탐과 Precision·Recall
가상 제조 이상점수 CSV로 두 알람 기준의 Confusion Matrix·Precision·Recall·오탐률을 계산하고 시계열 데이터 누수 및 인과 추론의 한계를 이해합니다.
제조 데이터 검증 실습 — Wafer/Lot 중복·재검·제품 구성 효과 분석
가상 Wafer Test CSV로 중복·재검·결측을 제외하고 최초 수율과 제품별/전체 집계 차이를 비교하며 원인 오판을 막는 실습입니다.
고객 품질 문제해결 실습 — 8D·RCA·CAPA와 재발 방지
고객 불량 접수부터 영향 범위·격리, 전기적 재현, 물리 분석, 검증된 원인, 시정 조치·효과 확인까지 교육용 사례로 연습합니다.